利用 pyspider 框架抓取猫途鹰酒店信息实战指南
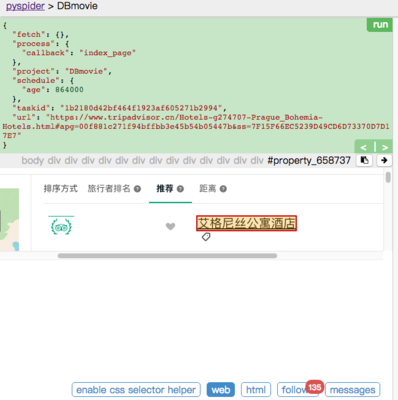
引言\n\n猫途鹰(Tripadvisor)是全球知名的旅游平台,汇集了大量酒店、餐厅和景点的评价信息。对于旅游行业分析、竞品调研或学术研究而言,抓取猫途鹰的酒店信息具有重要价值。pyspider 是一个强大的 Python 爬虫框架,支持分布式抓取、任务调度和可视化监控,非常适合用于此类数据采集任务。本文将详细介绍如何利用 pyspider 框架抓取猫途鹰酒店信息。\n\n## 环境准备\n\n1. 安装 pyspider:pyspider 支持 Python 2.7 和 Python 3.5+,推荐使用 Python 3.6+。通过 pip 安装:\n `bash\n pip install pyspider\n `\n 注意:pyspider 依赖的某些库(如 pycurl)可能需要系统级依赖,在 Windows 上可下载预编译包,在 Linux/macOS 上需安装 libcurl 开发包。\n\n2. 启动 pyspider:安装完成后,在命令行运行 pyspider all 启动 WebUI,默认地址为 http://localhost:5000。\n\n3. 分析目标网站:猫途鹰酒店页面结构复杂,且可能有反爬机制(如动态加载、验证码、IP 限制)。建议先手动浏览酒店列表页和详情页,确定需要抓取的字段(酒店名称、评分、评论数、价格、地址、设施等),并查看页面 HTML 结构以编写解析规则。\n\n## 编写爬虫脚本\n\n在 pyspider WebUI 中创建新项目,编写如下示例脚本(以猫途鹰酒店列表页为例):\n\n`python\nfrom pyspider.libs.basehandler import *\nimport re\nimport json\n\nclass Handler(BaseHandler):\n crawlconfig = {\n 'headers': {\n 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36',\n 'Accept-Language': 'en-US,en;q=0.9',\n },\n 'proxy': 'http://yourproxy:port', # 如需代理\n }\n\n @every(minutes=24 * 60)\n def onstart(self):\n # 起始 URL 可以是酒店列表页,需替换为实际目标链接\n self.crawl('https://www.tripadvisor.com/Hotels-g187147-ParisIledeFrance-Hotels.html', callback=self.indexpage)\n\n @config(age=10 24 60 * 60)\n def indexpage(self, response):\n # 解析酒店列表页,提取详情页链接\n for link in response.doc('a.propertytitle').items():\n url = link.attr.href\n if url:\n self.crawl(url, callback=self.detailpage)\n # 翻页处理\n nextpage = response.doc('a.next').attr.href\n if nextpage:\n self.crawl(nextpage, callback=self.indexpage)\n\n @config(priority=2)\n def detailpage(self, response):\n # 解析酒店详情页,提取所需字段\n name = response.doc('h1#HEADING').text()\n rating = response.doc('span.uibubblerating').attr.alt or ''\n reviewcount = response.doc('span.reviewCount').text()\n price = response.doc('div.price').text()\n address = response.doc('span.street-address').text()\n facilities = [item.text() for item in response.doc('div.hotel-features div').items()]\n\n # 数据清洗\n reviewcount = re.sub(r'\\D', '', reviewcount)\n price = re.sub(r'[^0-9]', '', price)\n\n return {\n 'url': response.url,\n 'name': name,\n 'rating': rating,\n 'reviewcount': int(reviewcount) if reviewcount else 0,\n 'price': int(price) if price else None,\n 'address': address,\n 'facilities': facilities,\n }\n`\n\n## 处理反爬与动态内容\n\n猫途鹰可能会对频繁请求进行限制,常见反爬措施包括:\n\n- IP 封锁:通过购买代理 IP 池,在 crawl<em>config 中设置 proxy,或使用 pyspider 的代理插件。\n- 验证码:可接入手动打码平台或使用 OCR 识别,但需注意合法合规。\n- 动态加载:猫途鹰部分内容通过 JavaScript 异步加载,pyspider 默认不执行 JS。此时可借助 pyspider 的 PhantomJS 支持(需配置 'fetch</em>type': 'js'),或在爬取前分析 XHR 请求,直接抓取 API 接口。\n- 请求头与随机延迟:在 crawl_config 中设置合理 User-Agent,并通过 self.crawl(..., age=0, priority=1) 控制抓取频率节奏。\n\n## 使用建议(处理提示“途鹰信息”)\n\n子指令提到了“途鹰信息”,可能有需要利用这一点。方案目标其实是单一的抓取完成后,如何提取利用。因此需要注意:或许系统需要抓取的除了用这些界面可视属性额外可以单独考虑做结果可视图、或者再入库进行后端数据过滤和需要 API 服务的应用结合其他行业爬取其规范规则不应抓指定字汇总信息偏离案例的题材/文不清晰的情况。\n\n使用子“输入又又件保”(即输出的题材证据结构所带的特定子含义中的可可能和潜落逻辑)都安排和查询关键名称输入关系机制的核心样例、完善组件必要附件的命名再确认和转化并且体现收集代码过程相关清楚的可视方式。”}…
` 如若转载,请注明出处:http://www.silujingxuan.com/product/21.html
更新时间:2026-10-26 07:15:43